
勒索軟體過去一向背後都有人在操作:由人挑選目標、取得或購買存取權、執行工具,並向受害者勒索贖金。但資安公司Sysdig本月揭露、命名為「JADEPUFFER」的一起入侵事件中,卻沒有人這麼做。根據該公司報告,一個大型語言模型(LLM)代理自行入侵一套正式營運中的系統、竊取憑證、逐步深入、加密資料庫、刪除原始資料,並留下勒索訊息。整個過程幾乎即時完成,由AI自行決定並排序每個步驟,入侵到造成損害之間完全沒有人類介入。
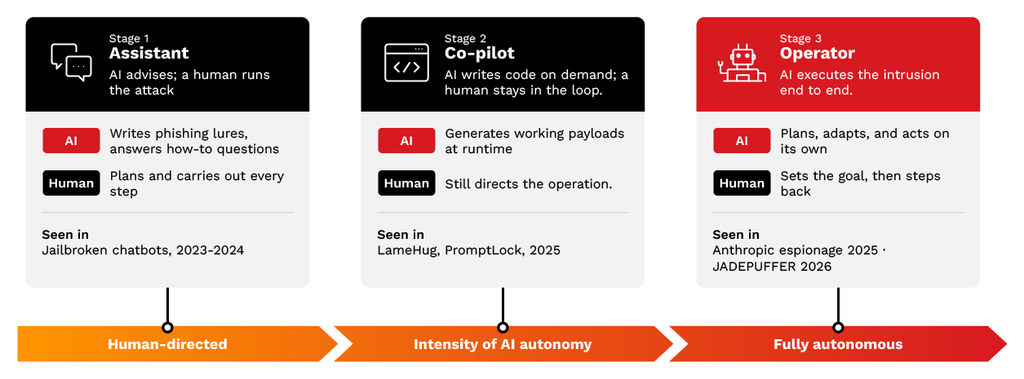
這正是Anthropic在2025年11月所描述的轉變:AI從「顧問」變成「操作者」。當時一個與國家有關的駭客組織,利用Claude模型「不只用來提供建議,而是直接執行攻擊本身」。JADEPUFFER是同樣的演進,只是把目標從間諜活動換成了勒索牟利。
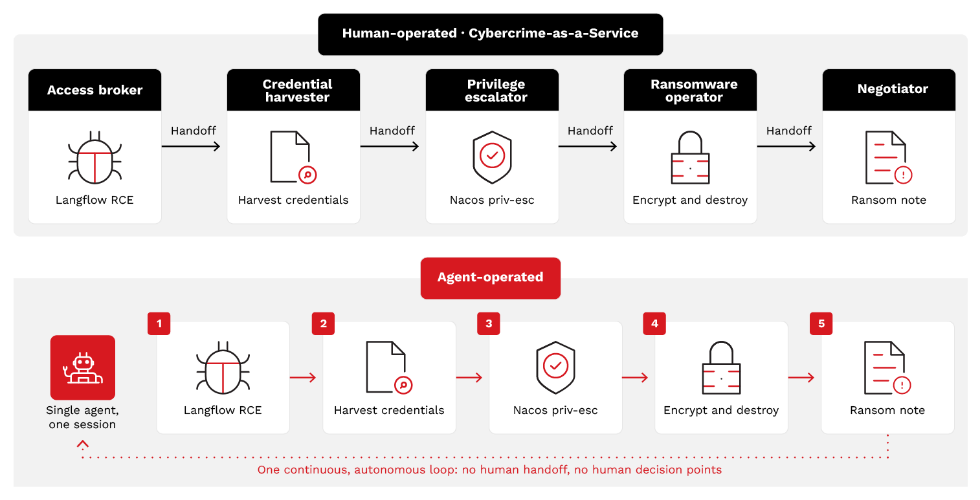
這也呼應TrendAI威脅研究團隊長期追蹤的方向。團隊在2025年12月發布的研究即指出,網路犯罪型態將從「犯罪即服務」(由真人整合購買犯罪工具與服務)演變為「犯罪即幫手」(由AI代理主導整起行動)。該報告稱JADEPUFFER為首個「代理式勒索軟體」,顯示AI在入侵行動中的角色已從單純協助草擬內容,一路升級到親自主導整起攻擊(圖1)。
演進脈絡:通往這一步的四起案例
JADEPUFFER是過去兩年AI輔助攻擊演進歷程中的最新一步。TrendAI在2026年1月發布的「犯罪AI現況」報告發現,相關生態系雖已「產業化」,卻仍受限於實務上的硬性限制,例如要求LLM即時撰寫自身程式碼的惡意軟體,只要供應商撤銷金鑰就會立刻失效,當時被形容為「具創新性,但尚不足以取代成熟手法」。
幾起獨立案例各自補上了一塊拼圖:
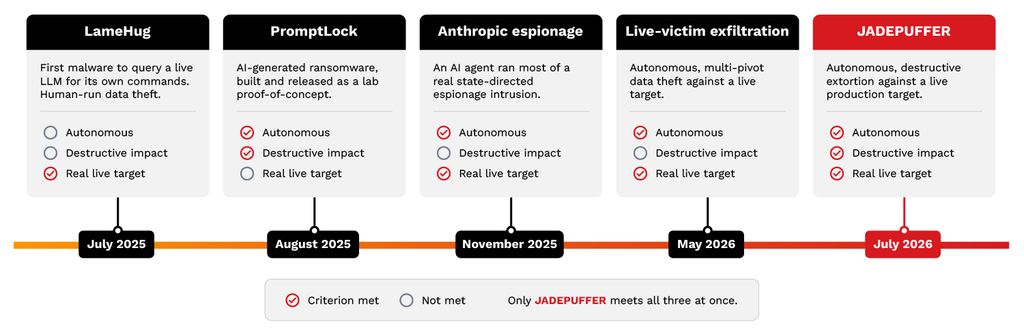
‧LameHug(亦稱PROMPTSTEAL,2025年7月曝光):首個被發現會即時查詢LLM以生成指令的惡意軟體,但屬人類操作的資料竊取工具,並非完整的勒索軟體攻擊鏈。
‧PromptLock(ESET於2025年8月發布):雖冠上「AI驅動勒索軟體」之名,實為學術性質的概念驗證,從未真正攻擊過受害者。
‧Anthropic於2025年11月揭露的案例:AI代理執行了一場真實入侵的大部分步驟,但屬國家指使的間諜活動,聚焦於竊取資料而非摧毀資料。
‧另一起發生在約七週前、具自主自我修正能力的入侵行動:觸及真實受害者,但止步於資料外洩,未進一步造成破壞。
JADEPUFFER首度同時集齊三項要素:端到端、完全由代理主導的攻擊鏈;具破壞性、以勒索為目的的實際影響;以及真實的正式環境目標,如圖2所示。
AI代理如何一手主導整起攻擊
TrendAI先前的研究將犯罪用途的代理式(Agentic)架構分為三層:負責執行的「代理層」、負責規劃應變的「協調層」,以及提供決策依據的「資料層」。在JADEPUFFER事件中,負責規劃與應變的協調層,就是模型本身,而非人類操作者。
根據Sysdig報告,AI代理是透過對外開放的AI工作流程平台Langflow中一個未修補、無需驗證即可利用的遠端程式碼執行(RCE)漏洞(CVE-2025-3248,CVSS評分9.8,已於Langflow 1.3.0版修補,2025年5月列入CISA已知遭利用漏洞目錄)取得初始入侵。取得存取權後,它竊取了雲端與AI供應商憑證,進一步觸及一套仍使用預設密碼的MinIO物件儲存服務,再轉向Nacos設定伺服器及其背後的正式資料庫。它串連一個2021年的Alibaba Nacos身分驗證繞過漏洞(CVE-2021-29441)與目標從未輪換過的預設簽章金鑰,偽造出管理員權杖,藉此提升權限並植入後門帳號。
它以每30分鐘回報一次的排程工作維持存取權,接著加密約1,342筆Nacos設定資料紀錄、刪除原始資料表,並留下勒索訊息——全程由單一AI代理以一個連續不間斷的循環獨自完成(圖3)。
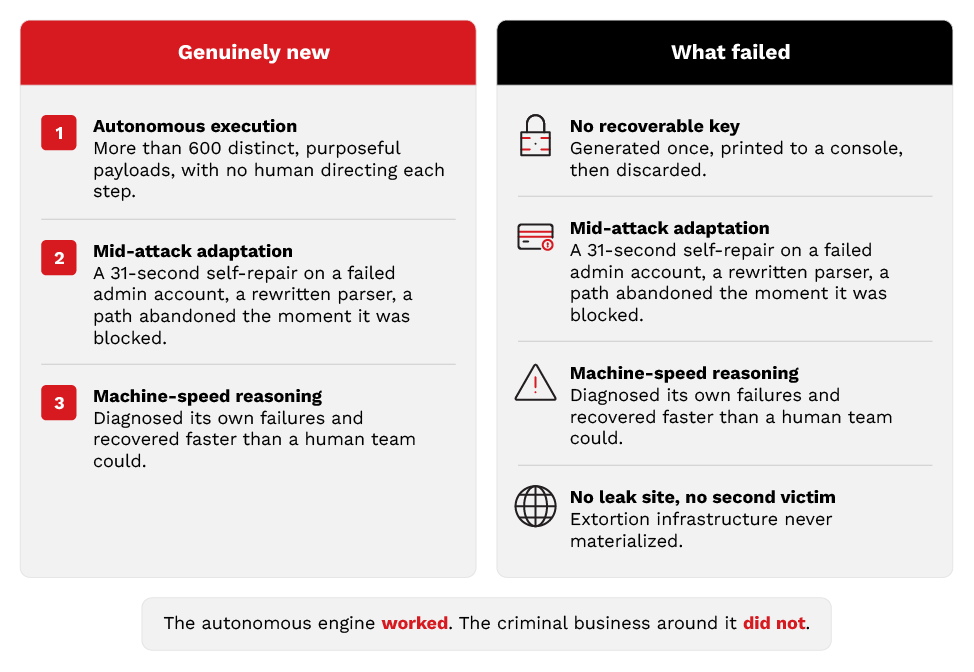
AI代理在壓縮的時間內發出超過600個各自獨立、具明確目的的攻擊酬載。當它建立的後門帳號登入失敗時,它自行診斷出原因(密碼雜湊值格式錯誤),刪除有問題的帳號、重新產生正確雜湊值、重新建立帳號並確認可登入,整個過程僅約31秒;當某個儲存服務回傳非預期格式的資料時,它重寫了自己的解析程式碼;當某條攻擊路徑偵測到有自訂密鑰存在,它立刻放棄該路徑。這種即時改寫、繞過障礙的模式,比較像是一個操作者在推理自己觀察到的狀況,而非依循固定腳本或人類的操作清單。
AI代理主導的攻擊,如何改變防禦方的處境
AI代理主導的攻擊透過以下三種方式來改變防禦方的處境:
一、幾乎不留下可供封鎖的線索
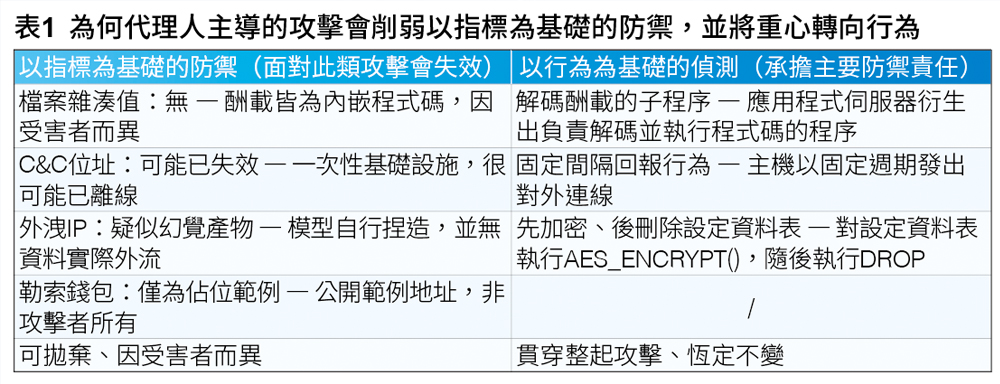
傳統勒索軟體會重複使用工具、執行檔與基礎設施,這也是業界大量防禦工作建立在「分享並封鎖入侵指標(IOC)」上的原因。但JADEPUFFER幾乎沒有留下這類線索:沒有檔案雜湊值(因為酬載皆為內嵌程式碼,等同針對這名受害者量身訂做);命令與控制位址很可能已失效;資料外洩目的地疑似是模型自行捏造的;勒索收款地址則是從公開技術文件複製而來的範例。
防禦重心因此必須從「指標」轉向「行為與手法」,較持久有效的訊號包括:應用程式伺服器衍生出解碼並執行酬載的子程序、以固定間隔回報的排程工作,或是資料庫先加密設定資料表、再將其刪除的行為模式(表1)。
二、AI代理會「自述」意圖,但部分內容不實
AI代理的酬載中含有大量白話文字註解,說明自己在做什麼、為何要這麼做(例如將某資料庫標註為「高投報率」後才刪除),這是防禦方過去罕有機會取得的證據型態,有助理解動機與重建時間軸。
但同樣的自述內容中也包含不實說法,最明顯的是聲稱資料已外洩至外部伺服器,實際上並無證據支持——這類似LLM常見的「幻覺」現象,即以十足自信陳述錯誤資訊。Anthropic的案例中也曾觀察到相同狀況。因此,AI代理對自身行為的描述只能視為「線索」,仍須獨立查證。
三、真正的新意在於自動化,失敗點在於變現
這起事件真正新穎之處,不是攻擊手法,而是AI代理獨力完成整起行動並自行修正錯誤。真正失敗的環節在於變現:加密金鑰只產生過一次、印在主控台上就沒有再儲存,代表即便付了贖金,資料也無法解密;勒索地址也並非攻擊者所有,而是公開比特幣文件中的範例地址;整起事件沒有設立資料外洩網站,也沒有出現第二個受害者。
就結果而言,這比較接近「單純的破壞」而非「成功的勒索」,但這正是「自主式勒索軟體確實可行」的早期徵兆:入侵環節完全站得住腳,只是變現環節尚未成熟(圖4)。
結語
TrendAI先前的VibeCrime研究曾指出,犯罪者採用代理式AI的速度一開始會緩慢,但一旦有組織證明此法有效,速度便會加快。JADEPUFFER還不是那個「證明有效」的時刻,但顯示這個時刻已觸手可及——修補對外平台、清除預設與未輪換憑證,這些措施本身都不新鮮,真正改變的是防禦方一旦被攻擊者搶先發現同樣缺口,所剩的應變時間將大幅縮短。
企業端也面臨相同壓力:隨著企業主動部署代理式AI,這類系統會透過不斷自我調整的循環呼叫工具、觸及資料、觸發工作流程,而非依循固定路徑,這正是其結果難以預測、追蹤或掌控的原因。TrendAI將「治理」視為掌控這種自主性的控制層,並將此能力打造進Agentic Governance Gateway中,使其能發掘並盤點代理、觀察行為、理解意圖、標記異常並落實政策。一家能妥善治理自身代理的企業,也更有能力揪出潛入自身環境中的惡意代理。
建議
以下提供防禦方、決策者、事件應變人員幾項建議:
給防禦方
‧優先建置以行為與手法為基礎的偵測機制:對應用程式伺服器衍生解碼酬載的子程序、固定間隔對外回報,以及對設定資料表執行大量加密後隨即刪除等行為進行告警。
‧修補並盤點對外開放的AI與自動化平台:確認所有Langflow執行個體皆升級至1.3.0以上版本,並將任何對外開放、未修補的執行個體視為現存風險。
‧輪換預設及長期未更換的密鑰:汰換原廠出貨即附帶的簽章金鑰,並清除預設服務憑證。這類憑證正是本起事件中兩個不同階段皆能得逞的關鍵原因。
給決策者
‧對AI系統套用「最小代理權限」原則:僅授予AI代理與自動化平台所需的最小存取權限,監看其與其他系統的互動,並要求高影響力操作須經核准。
給事件應變人員
‧為設定與中繼資料儲存保留離線、不可竄改的備份:本起事件顯示,存放在資料庫內的備份,對擁有寫入權限的攻擊者毫無防護作用。
‧在分析初期,將AI代理的自述內容視為未經查證的資訊:其內嵌註解雖是有用的切入點,但部分內容可能並不真實。
<本文作者:TrendAI威脅研究中心 本文出自趨勢科技資安部落格,是由趨勢科技資安威脅研究員、研發人員及資安專家全年無休協力合作,發掘消費者及商業經營所面臨層出不窮的資安威脅,進行研究分析、分享觀點並提出建議。>